
Zum Inhalt springen
Kostenloses ErstgesprächErstgespräch

Qvestcon News

Eigener KI-Modellbetrieb senkt Coding-Kosten um rund 90 Prozent

Ein britisches Fintech hat die Kosten für KI-gestützte Pro­gram­mie­rung nach eigenen Angaben innerhalb von weniger als einem Jahr um rund 90 Prozent gesenkt. Es betreibt ein Open-Weight-Modell (Modell mit frei verfügbaren Gewichten) auf 56 Gra­fik­pro­zes­so­ren vom Typ Nvidia B200 in der eigenen Infrastruktur. Die Kosten liegen laut dem Leiter Betrieb und Infrastruktur bei rund 30 Cent pro Million Eingabe- und Ausgabe-Tokens. Das ist etwa ein Zehntel der früheren Kosten für kommerzielle Dienste. Ob die Hardware-Anschaffung in dieser Rechnung vollständig enthalten ist, geht aus den Berichten nicht hervor. Alle Zahlen stammen vom Unternehmen selbst. Auslöser waren Budgetgrenzen, nachdem einzelne Entwickler 1.000 oder 10.000 US-Dollar im Monat ausgegeben hatten, ohne dass sich das in ent­spre­chen­den Ergebnissen zeigte. Das Unternehmen nennt für den Einsatz 60 Prozent kürzere Pro­gram­mier­zeit und 70 Prozent kürzere Durchlaufzeit. Den größten Nutzen sieht es beim Debugging und bei der Ticket­be­ar­bei­tung. Wichtig für die Praxis: Das Modell verarbeitet nur Text. Anfragen mit Bildern leitet das Unternehmen über einen Router an andere Modelle weiter, kommerzielle Dienste bleiben für Ausnahmefälle verfügbar. Für Banken und Versicherer mit KI-Einsatz in der Entwicklung bietet das drei Ansatzpunkte. Erstens den Verbrauch je Team und Anwen­dungs­fall messen. Zweitens prüfen, welche Aufgaben ein selbst betriebenes Modell übernehmen kann. Drittens klären, welche Daten den eigenen Betrieb nie verlassen dürfen. Eine eigene Rechnung mit Hardware, Betrieb und Personal gehört vor jede Entscheidung.

Datenschutz

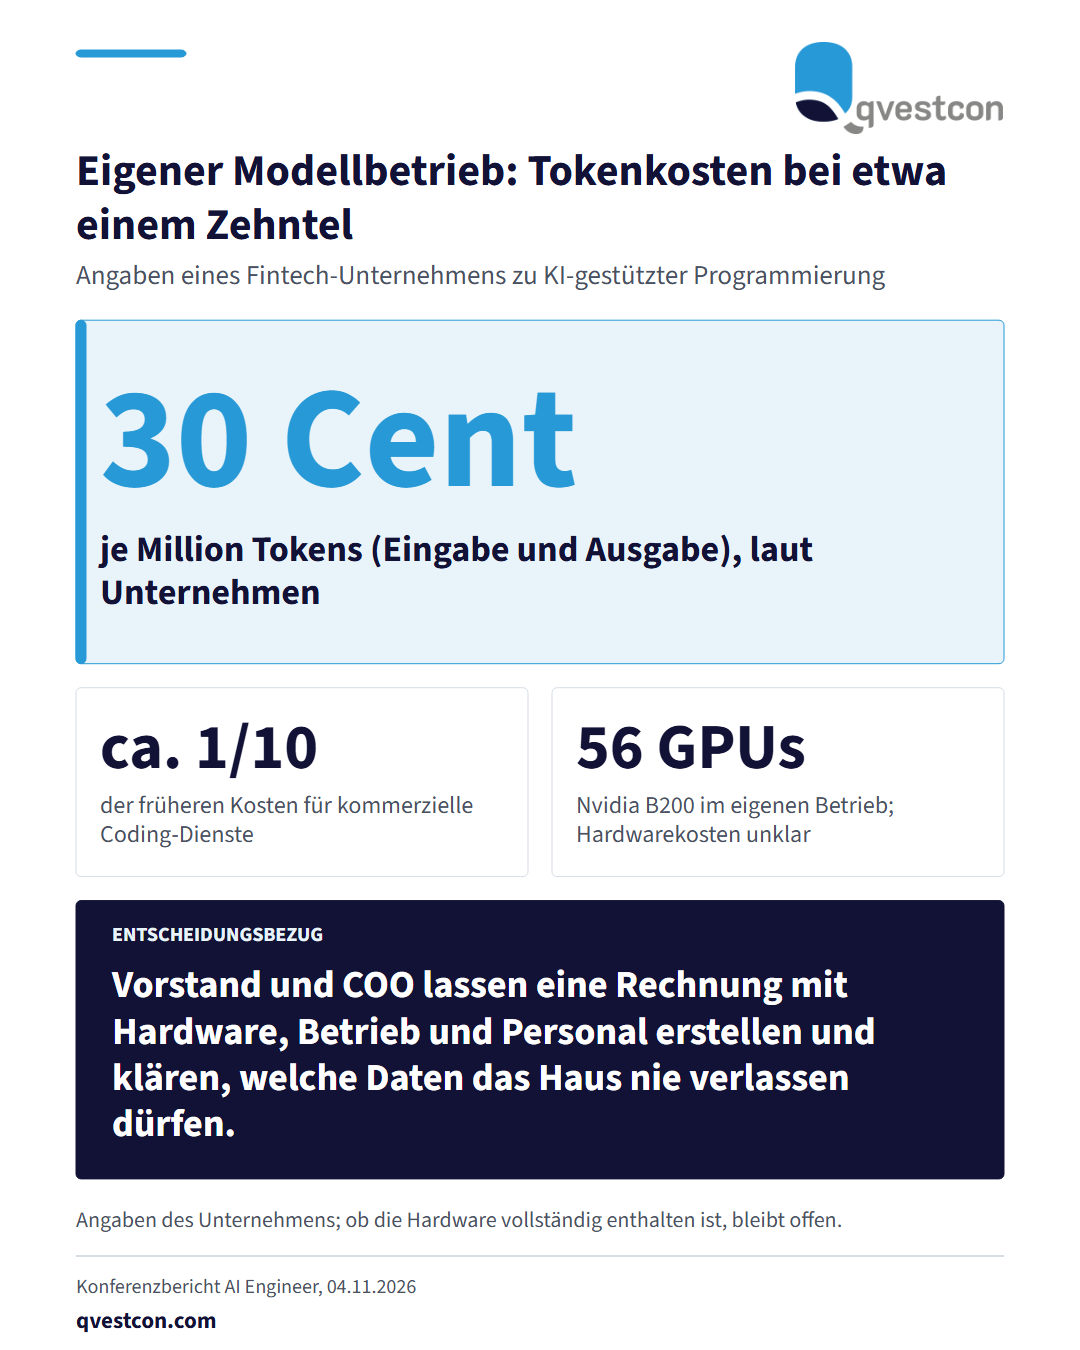
Drei Kernzahlen: rund 30 Cent je Million Tokens, etwa ein Zehntel der früheren Kosten, 56 Grafikprozessoren im eigenen Betrieb.

Ein britisches Fintech hat die Kosten für KI-gestützte Pro­gram­mie­rung nach eigenen Angaben innerhalb von weniger als einem Jahr um rund 90 Prozent gesenkt. Es betreibt ein Open-Weight-Modell (Modell mit frei verfügbaren Gewichten) auf 56 Gra­fik­pro­zes­so­ren vom Typ Nvidia B200 in der eigenen Infrastruktur. Die Kosten liegen laut dem Leiter Betrieb und Infrastruktur bei rund 30 Cent pro Million Eingabe- und Ausgabe-Tokens. Das ist etwa ein Zehntel der früheren Kosten für kommerzielle Dienste. Ob die Hardware-Anschaffung in dieser Rechnung vollständig enthalten ist, geht aus den Berichten nicht hervor. Alle Zahlen stammen vom Unternehmen selbst. Auslöser waren Budgetgrenzen, nachdem einzelne Entwickler 1.000 oder 10.000 US-Dollar im Monat ausgegeben hatten, ohne dass sich das in ent­spre­chen­den Ergebnissen zeigte. Das Unternehmen nennt für den Einsatz 60 Prozent kürzere Pro­gram­mier­zeit und 70 Prozent kürzere Durchlaufzeit. Den größten Nutzen sieht es beim Debugging und bei der Ticket­be­ar­bei­tung. Wichtig für die Praxis: Das Modell verarbeitet nur Text. Anfragen mit Bildern leitet das Unternehmen über einen Router an andere Modelle weiter, kommerzielle Dienste bleiben für Ausnahmefälle verfügbar. Für Banken und Versicherer mit KI-Einsatz in der Entwicklung bietet das drei Ansatzpunkte. Erstens den Verbrauch je Team und Anwen­dungs­fall messen. Zweitens prüfen, welche Aufgaben ein selbst betriebenes Modell übernehmen kann. Drittens klären, welche Daten den eigenen Betrieb nie verlassen dürfen. Eine eigene Rechnung mit Hardware, Betrieb und Personal gehört vor jede Entscheidung.

Ori­gi­nal­quelle: it-daily →

Diese Einordnung bezieht sich auf die verlinkte Ori­gi­nal­quelle. Sie ist keine Rechts­be­ra­tung im Einzelfall.

Kostenloses Erstgespräch anfragen →

Weitere Meldungen in Datenschutz · alle Qvestcon-News