
Zum Inhalt springen
Kostenloses ErstgesprächErstgespräch

Qvestcon News

Kon­text­fens­ter: Wie viel ein KI-Modell pro Anfrage liest

Das Kon­text­fens­ter ist die maximale Menge an Informationen, die ein großes Sprachmodell (Large Language Model, LLM) bei einer einzigen Anfrage berück­sich­ti­gen kann. Gemessen wird es in Token, das sind Texteinheiten wie Wörter, Wortteile, Zahlen oder Satzzeichen. Aktuelle Modelle verarbeiten mehrere Hun­dert­tau­send bis über eine Million Token und damit mehrere hundert Seiten Text. Belegt wird das Fenster nicht nur durch das Dokument. Es enthält auch die Anfrage, die verdeckten Grundregeln des Modell­an­bie­ters (System-Prompts), den bisherigen Gesprächs­ver­lauf, bei Systemen mit Wis­sens­da­ten­bank (Retrieval-Augmented Generation, RAG) die gefundenen Textstellen und die erzeugte Antwort. Informationen außerhalb des Fensters kann das Modell nicht direkt einbeziehen. Mehr Kontext ist nicht automatisch besser: Mit wachsender Token-Zahl kann die Genauigkeit wieder sinken (Lost-in-the-Middle-Effekt), außerdem steigen Rechenaufwand, Kosten pro Anfrage und Antwortzeit. Für Banken und Versicherer, die KI auf Verträge, Akten oder Richtlinien ansetzen, lohnt vor dem Einsatz eine einfache Prüfung: Passt das Material samt Anfrage und Antwort ins Fenster, und welche Textstellen braucht das Modell tatsächlich?

Datenschutz

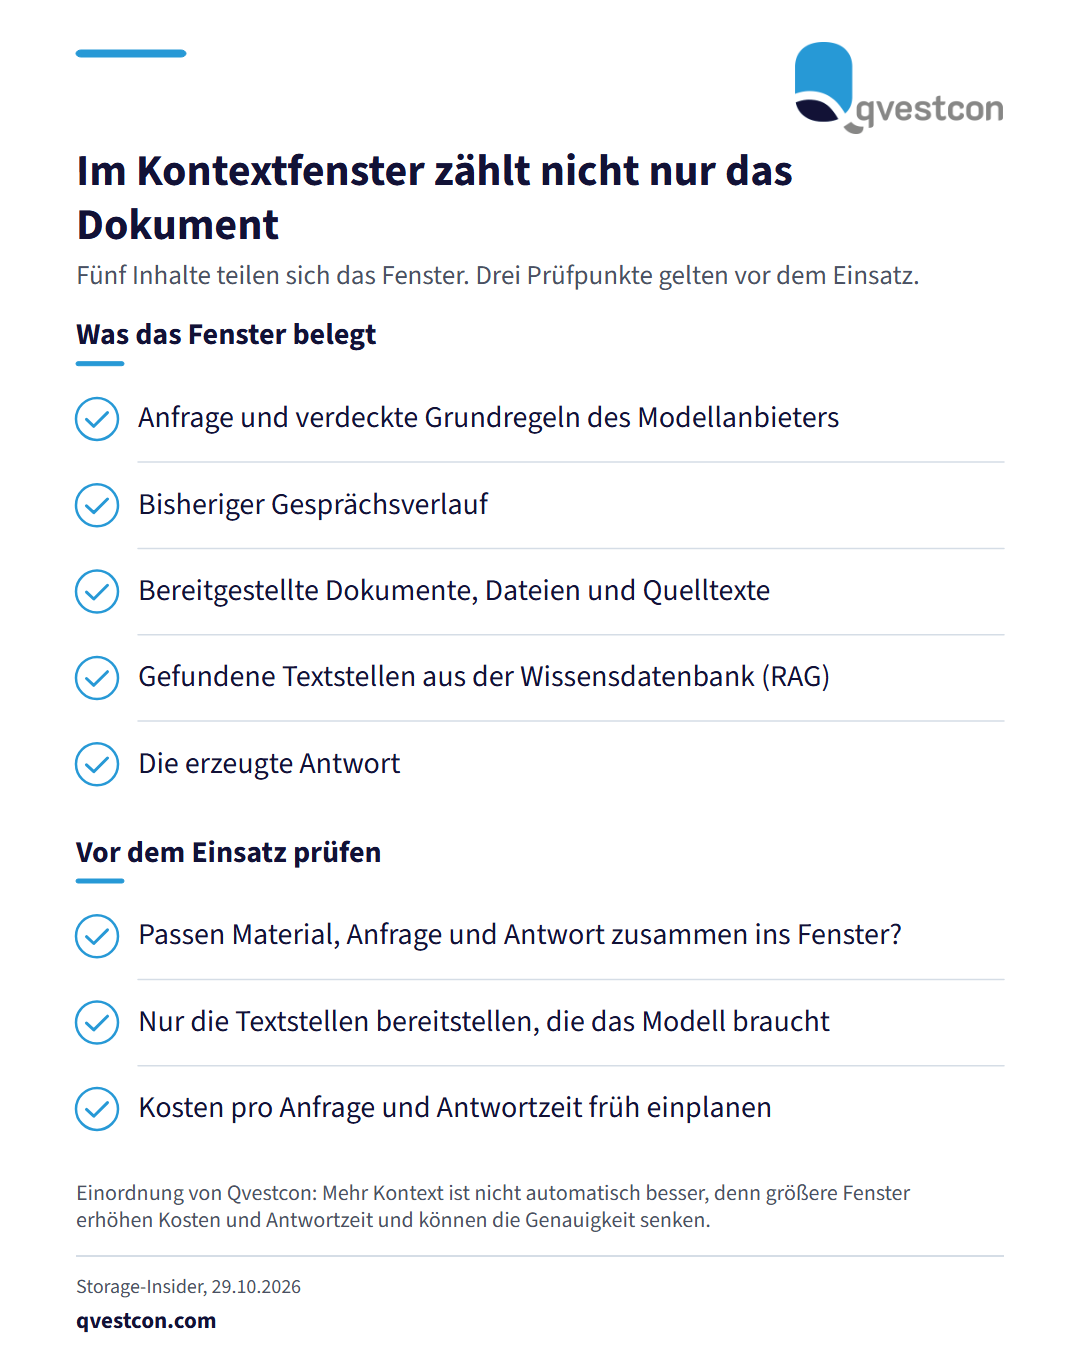
Checkliste in zwei Gruppen. Die erste nennt fünf Inhalte, die das Kontextfenster eines KI-Modells belegen. Die zweite nennt drei Prüfpunkte vor dem Einsatz auf Verträge, Akten und Richtlinien.

Das Kon­text­fens­ter ist die maximale Menge an Informationen, die ein großes Sprachmodell (Large Language Model, LLM) bei einer einzigen Anfrage berück­sich­ti­gen kann. Gemessen wird es in Token, das sind Texteinheiten wie Wörter, Wortteile, Zahlen oder Satzzeichen. Aktuelle Modelle verarbeiten mehrere Hun­dert­tau­send bis über eine Million Token und damit mehrere hundert Seiten Text. Belegt wird das Fenster nicht nur durch das Dokument. Es enthält auch die Anfrage, die verdeckten Grundregeln des Modell­an­bie­ters (System-Prompts), den bisherigen Gesprächs­ver­lauf, bei Systemen mit Wis­sens­da­ten­bank (Retrieval-Augmented Generation, RAG) die gefundenen Textstellen und die erzeugte Antwort. Informationen außerhalb des Fensters kann das Modell nicht direkt einbeziehen. Mehr Kontext ist nicht automatisch besser: Mit wachsender Token-Zahl kann die Genauigkeit wieder sinken (Lost-in-the-Middle-Effekt), außerdem steigen Rechenaufwand, Kosten pro Anfrage und Antwortzeit. Für Banken und Versicherer, die KI auf Verträge, Akten oder Richtlinien ansetzen, lohnt vor dem Einsatz eine einfache Prüfung: Passt das Material samt Anfrage und Antwort ins Fenster, und welche Textstellen braucht das Modell tatsächlich?

Ori­gi­nal­quelle: Storage-Insider →

Diese Einordnung bezieht sich auf die verlinkte Ori­gi­nal­quelle. Sie ist keine Rechts­be­ra­tung im Einzelfall.

Kostenloses Erstgespräch anfragen →

Weitere Meldungen in Datenschutz · alle Qvestcon-News