
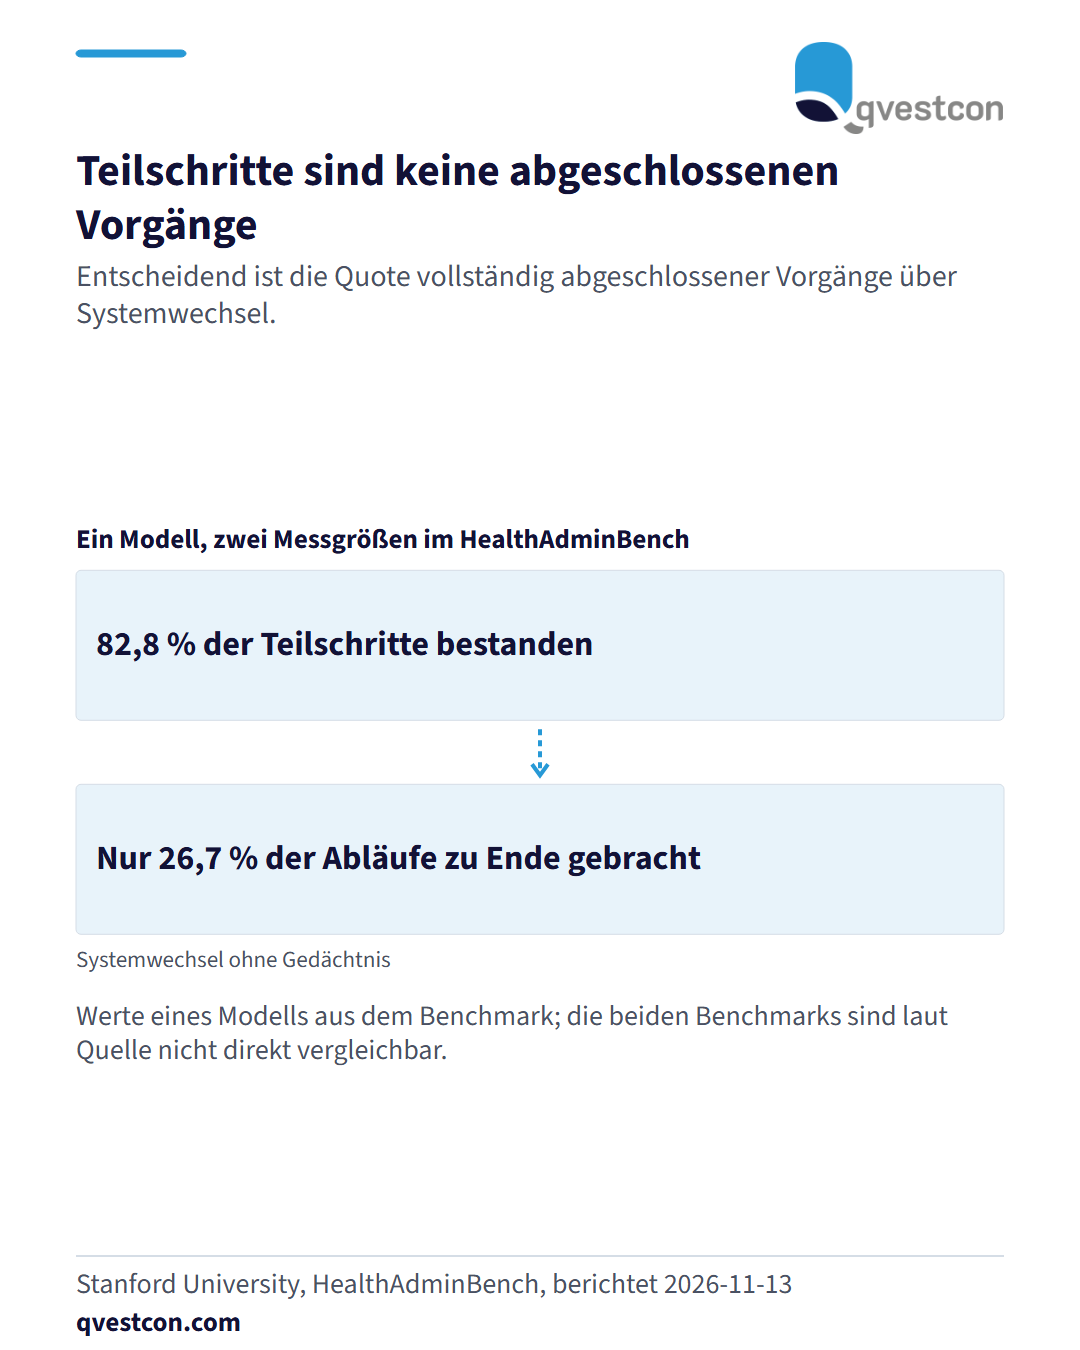
Zwei Benchmarks der Stanford University prüfen Agenten mit Künstlicher Intelligenz (KI) an realistischen Aufgaben aus Klinik und Verwaltung. Im PhysicianBench löste das beste Modell 46 Prozent von 100 Aufgaben im ersten Versuch. Im HealthAdminBench erledigte das beste Modell 36,3 Prozent von 135 Aufgaben vollständig. Die Schwäche lag weniger im Fachwissen als in der Koordination über Patientenakte, Kostenträgerportale und Faxsystem hinweg. Agenten hielten frühe Informationen nicht fest. Sie korrigierten eigene Fehler selten. Für Versicherer und Banken liefert das einen Prüfmaßstab: Verantwortliche testen Agenten an vollständigen Prozessketten mit Systemwechseln. Sie messen die Quote vollständig abgeschlossener Vorgänge statt einzelner Teilschritte. Erst dann entscheiden sie über einen produktiven Einsatz.