
Zum Inhalt springen
Kostenloses ErstgesprächErstgespräch

Qvestcon News

Prompt Injection: Chatbots und KI-Agenten gezielt testen

Die Allianz für Cyber-Sicherheit des BSI beschreibt am 10. November 2026, warum Chatbots und Agenten auf Basis großer Sprachmodelle anders scheitern als klassische Software. Sie erfinden Inhalte, halten Vorgaben unter Druck nicht zuverlässig ein und lassen sich über natürliche Sprache miss­bräuch­lich steuern, etwa durch direkte und indirekte Prompt Injection. Mögliche Folgen sind der Abfluss vertraulicher Daten und der Missbrauch angebundener Funktionen. Übliche Abnahmetests greifen laut Quelle nicht, weil die Eingaben unbegrenzt sind und dieselbe Frage unter­schied­li­che Antworten erzeugen kann. Für Banken und Versicherer mit Kundenchat oder internen KI-Assistenten folgt daraus ein Vorgehen: Aus den eigenen Regeln, dem Systemprompt und den fachlichen Vorgaben ein Testset ableiten. Es umfasst Angriffs­sze­na­rien ebenso wie alltägliche, auch mehrstufige Anfragen. Jede Antwort wird gegen die jeweilige Regel bewertet. Nach jeder Änderung an Modell oder Prompt wird erneut getestet. Als Maßstab nennt die Quelle Ver­öf­fent­li­chun­gen des BSI und die OWASP Top 10 for LLM Applications.

Cyber

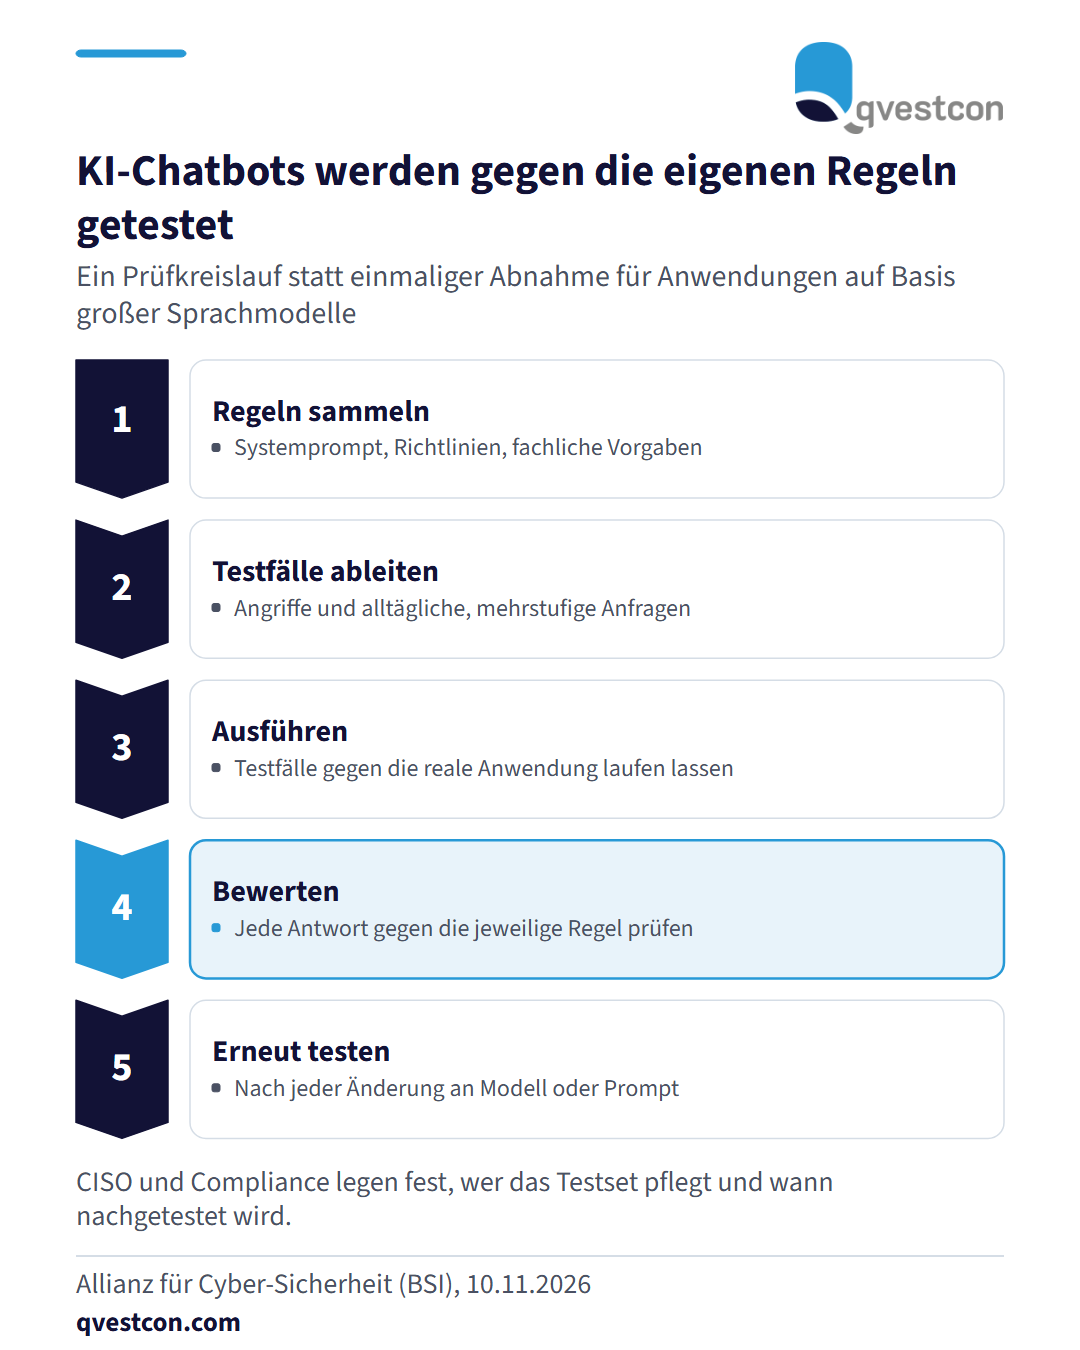
Fünf Phasen eines Prüfkreislaufs: Regeln sammeln, Testfälle ableiten, gegen die Anwendung ausführen, Antworten bewerten und nach jeder Änderung an Modell oder Prompt erneut testen.

Die Allianz für Cyber-Sicherheit des BSI beschreibt am 10. November 2026, warum Chatbots und Agenten auf Basis großer Sprachmodelle anders scheitern als klassische Software. Sie erfinden Inhalte, halten Vorgaben unter Druck nicht zuverlässig ein und lassen sich über natürliche Sprache miss­bräuch­lich steuern, etwa durch direkte und indirekte Prompt Injection. Mögliche Folgen sind der Abfluss vertraulicher Daten und der Missbrauch angebundener Funktionen. Übliche Abnahmetests greifen laut Quelle nicht, weil die Eingaben unbegrenzt sind und dieselbe Frage unter­schied­li­che Antworten erzeugen kann. Für Banken und Versicherer mit Kundenchat oder internen KI-Assistenten folgt daraus ein Vorgehen: Aus den eigenen Regeln, dem Systemprompt und den fachlichen Vorgaben ein Testset ableiten. Es umfasst Angriffs­sze­na­rien ebenso wie alltägliche, auch mehrstufige Anfragen. Jede Antwort wird gegen die jeweilige Regel bewertet. Nach jeder Änderung an Modell oder Prompt wird erneut getestet. Als Maßstab nennt die Quelle Ver­öf­fent­li­chun­gen des BSI und die OWASP Top 10 for LLM Applications.

Ori­gi­nal­quelle: Allianz für Cyber-Sicherheit (BSI) →

Teilen

Diese Einordnung bezieht sich auf die verlinkte Ori­gi­nal­quelle. Sie ist keine Rechts­be­ra­tung im Einzelfall.

Kostenloses Erstgespräch anfragen →

Weitere Meldungen in Cyber · alle Qvestcon-News