
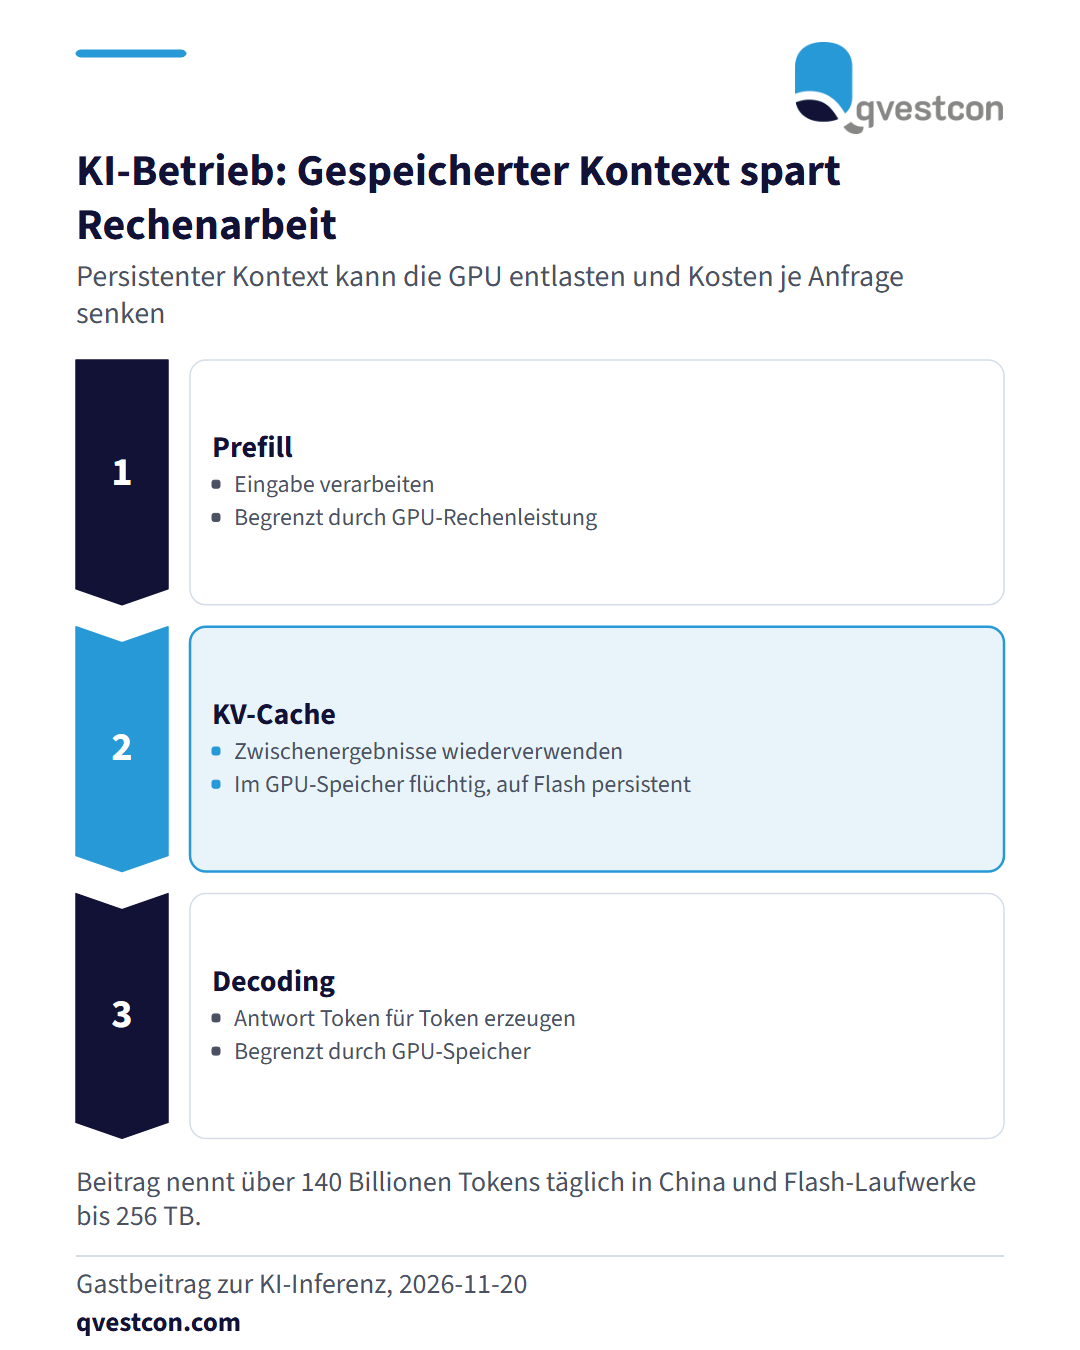
Jede Antwort eines Sprachmodells entsteht in zwei Phasen: Prefill verarbeitet die Eingabe und ist durch GPU-Rechenleistung begrenzt, Decoding erzeugt die Antwort Token für Token und ist durch GPU-Speicher begrenzt. Ein KV-Cache speichert Zwischenergebnisse, damit bereits verarbeiteter Kontext nicht neu berechnet wird. Im GPU-Speicher ist er flüchtig. Ein persistenter KV-Cache legt ihn auf Flash-Speicher ab, was nach Darstellung des Gastbeitrags GPU-Auslastung erhöhen und Kosten je Anfrage senken kann. Als Größenordnung nennt der Beitrag mehr als 140 Billionen Tokens täglich in China und Flash-Laufwerke mit bis zu 256 TB. Für IT und COO in Banken und Versicherern, die KI selbst betreiben, ist das als Einordnung von Qvestcon ein Hebel für die Betriebskostenplanung.